在 Claude Code 团队内部,约 90% 的生产代码均由 Claude 自主编写并完成审查。在这一极端规模下,如何通过确定性证据(Evidence)武装智能体以完成自我验证,成为整个工程体系的核心基石。本文系统揭秘 Claude Code 团队打造的端到端、基于属性与差分测试三大验证护栏,以及保证验证器自身公正客观的 9 项实战工程准则。
类别:工程架构与最佳实践 | 原文作者:Addy Osmani(Anthropic 技术专家) | 编译:资深科技观察 | 原文发布:2026 年 11 月 16 日
在 Claude Code 团队,我们绝大部分代码(约 90%)均由 Claude 自主编写并由其完成 Code Review。在如此庞大的自动化规模下,如何为我们的 Agent 配备一套能够以“事实证据(Evidence)”进行自我验证的机制,变得至关重要。
“验证闭环(Verification Loops)”是将更多复杂工作全权委托给 Claude 的核心基石。 缺乏这套闭环,你同一时间实际上只能运行一到两个 Claude 实例,因为所有细枝末节都必须由你亲自逐行人肉审查;而一旦构建起健壮的验证闭环,你就可以放心并发调度几十甚至上百个 Claude 并行工作。
赋予 Agent 验证自身产出的手段,是提升交付质量最行之有效的方法。在针对结构化文件生成的内部基准测试中,引入一个独立的打分器(Grader)依据严苛细则(Rubric)检查 Claude 的工作,相比单向的标准 Prompting 循环,将任务成功率最高提升了整整 10 个百分点,而且越是在难度最高的问题上收益越发显著。
过去极其昂贵、难以频繁运行的验证手段(测试用例、性能基准、行为规约、真实端到端全流程运行),现在委托给 Agent 构造的边际成本已近乎归零。如同编写业务逻辑一样,Agent 同样可以飞速生成测试、基准套件与行为 Spec。更妙的是,一旦生成完毕,这些测试和基准本身即是软件程序,可以被超高频反复执行,且几乎不额外消耗大模型的推理 Token。
此外,你还可以利用验证结果反哺迭代,彻底闭合这个正向增强回路。例如,如果 Agent 反复无法通过一项“检查日志中是否泄露用户隐私数据”的测试,你可以顺势编写一个自动化 Hook,或在 CLAUDE.md 中立下一条更明确的行为红线。这便能在绝大多数情况下从根源上杜绝同类问题的再次发生。
既然验证对于实现“高质量、高吞吐”的 AI 编码如此至关重要,那么在流水线中究竟该部署哪些测试类型?又该如何将它们体系化落地?本文将全面解答这些疑问,并首次深度公开 Claude Code 团队内部的核心工程流程。
# 一、并非所有测试都生而平等:最值得重金投入的 3 类测试
无论你选择哪种测试类型,首先都需要避开几类典型的工程陷阱:
- 如果你的测试存在偶发不稳定(Flaky Tests),这反而会教坏 Agent——诱导它养成“报错就无脑重跑”的恶习,而不是直面并修复有问题的业务代码;
- 如果测试耗时过慢,Agent 在批处理中的测试频次就会急剧下降,从而极大增加定位问题的排查难度;
- 最耗时的重型测试,最好严格安排在变更正式提交合并之前触发。
在此前提下,以下是作者认为最值得重金投入的三大测试类型:
# 1. 端到端测试(E2E tests)
如果精力有限只能聚焦于一种测试,请毫不犹豫地选择端到端测试(E2E)。E2E 测试描述的是用户的真实业务旅程——例如在电商系统中将商品加入购物车、进入结账流程、直至成功抵达确认页面。
E2E 测试之所以极其强大,在于它们极难被模型蒙混过关:要么整个功能链路完整跑通,要么直接亮红灯报错。同时,它们具有极其明确的完成判定标准(Done Criteria),并能一针见血地指出具体哪个环节发生了损坏。
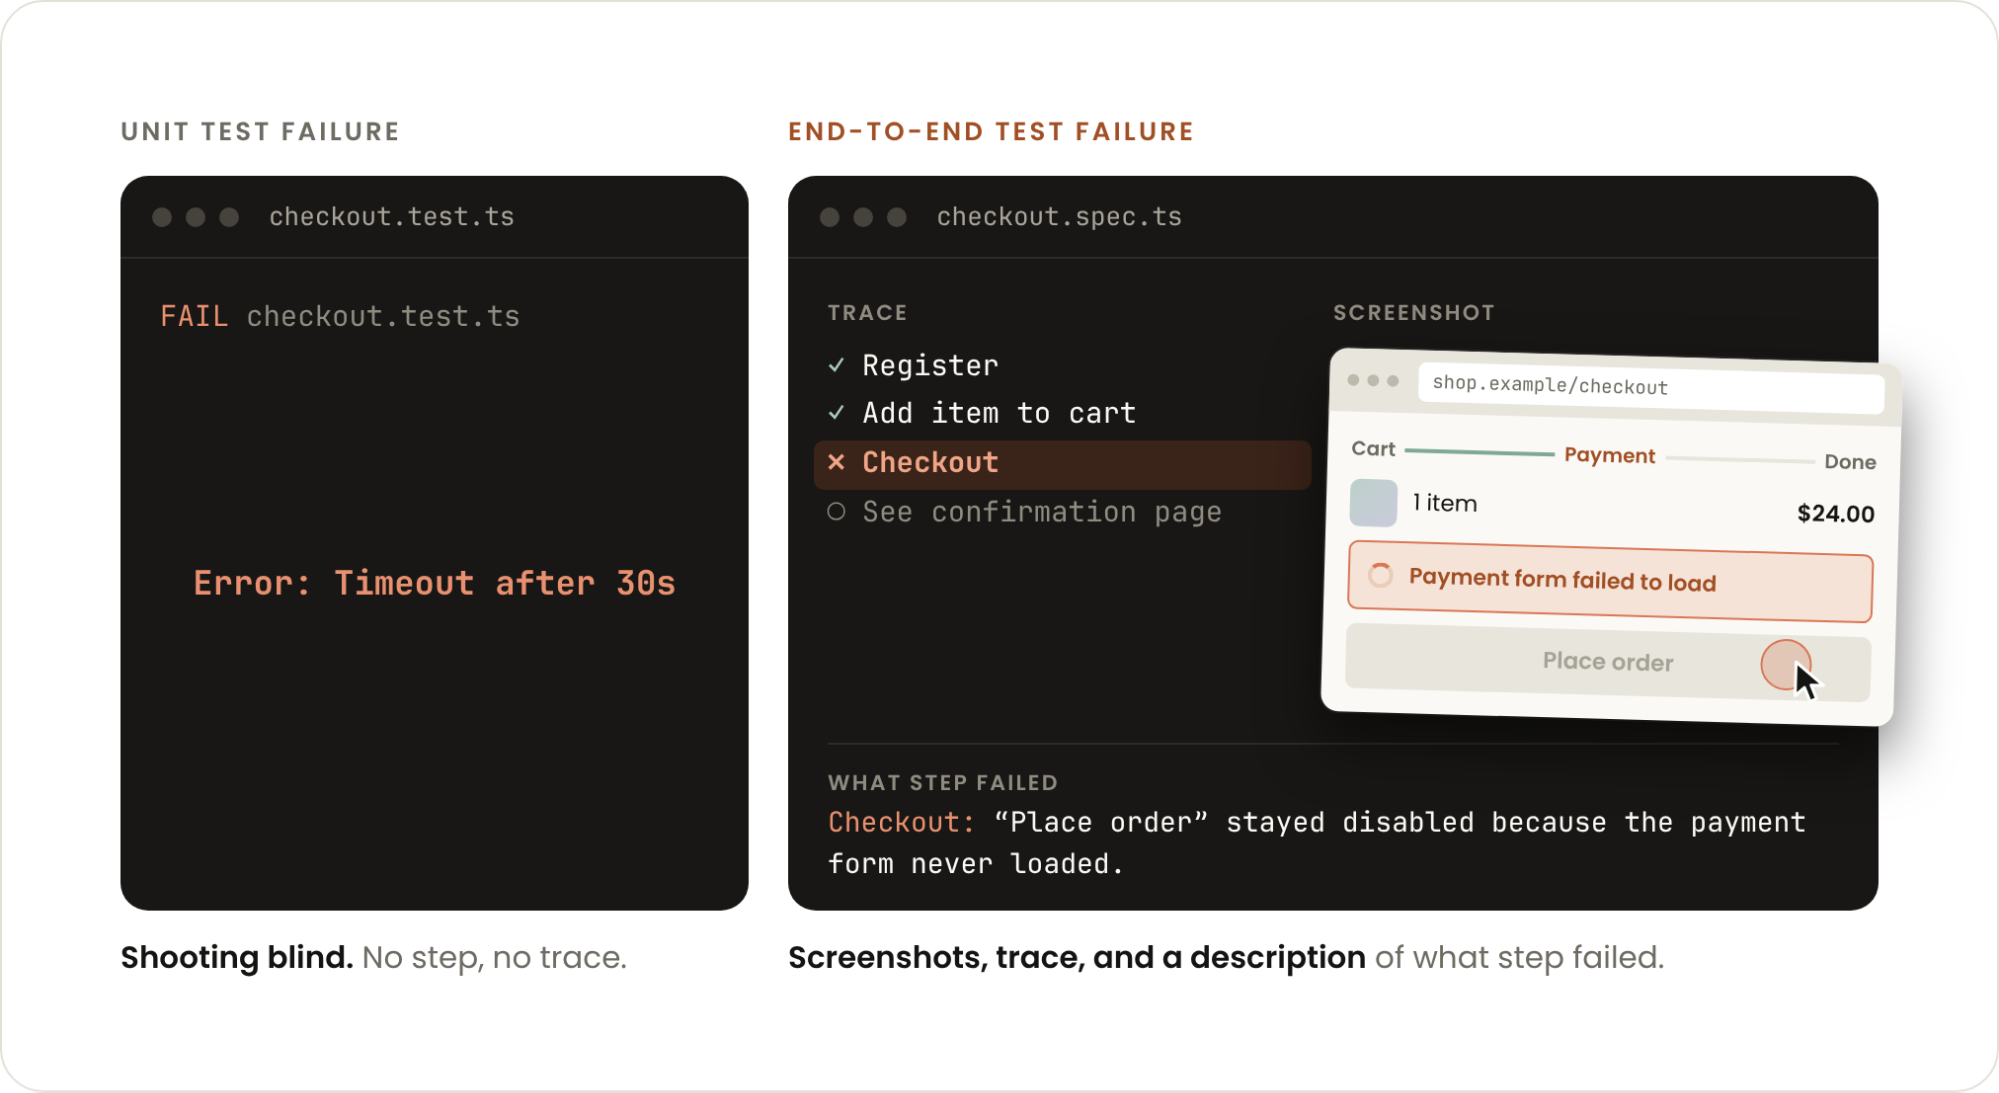
图注:FIG A —— 单元测试失败时可能只抛出一句模糊的“Error: Timeout after 30 seconds”(如同盲狙,缺乏上下文),而端到端测试不仅包含完整的执行步骤追踪,还能捕获页面现场截图并附带具体是哪个按钮或状态导致中断的详尽错误描述。
单元测试固然运行更快、环境干扰更少,但完全可能出现“单测全部绿灯、业务功能全面崩盘”的尴尬局面——这是因为此时无论是 Agent 还是单元测试本身,都未能理解全局任务的真实全貌。
在 E2E 测试中,最有效的做法是赋予 Agent 操控与观察真实运行系统的“手和眼”。你可以构建一个专门的 Skill,借助 Chrome DevTools Protocol(CDP)、移动端模拟器(Simulators)或自动化 API 测试套件,来拉起、驱动并全面审查实际运行的应用。
在这一过程中,“功能地图(Feature Map)”可作为 Agent 的行为蓝图与评分细则(Rubric):它以终为始地从真实用户视角出发,穷举各业务路径、快捷键组合、界面元素定位符(Selectors)以及明确的预期结果。
# 2. 基于属性的测试(Property tests):绝不可被打破的硬约束
很多传统测试的局限在于,它们仅仅覆盖了开发者事先预想到的出错场景。而属性测试(Property Tests)则专门扫射人类极易疏漏的边缘极端用例(Edge Cases)——而这恰恰是编码 Agent 频频翻车的重灾区。
你的起点是提炼并编写一条“你认为在任何情况下都绝不应该失败”的数学或逻辑断言;随后引入专业的属性测试库(如 JS/TS 的 fast-check、Python 的 Hypothesis、Rust 的 proptest 等),让测试库自动生成成千上万个极度刁钻的合成输入,穷尽一切可能去“证伪”你的断言。
在几乎每一个软件项目中,都天然存在诸多值得提炼的通用属性:
- 编解码对称性(Round-trip encoding):“如果将 X 编码序列化,随后再反序列化解码,必须能够 100% 还原为原始的 X”。这在数据解析、协议转换和持久化场景中坚不可摧;
- 状态不变式(Invariants):在系统所有状态流转中都必须永真成立的铁律,例如“账户余额在任何并发扣款下均不可为负数”;
- 幂等性(Idempotency):一个核心操作(如数据迁移 Migration、规格归一化 Normalization、失败重试 Retry)无论连续执行一次还是多次,系统最终产生的状态影响完全等同;
- 等价性(Equivalence):经过极限性能优化后的复杂算法,其输入输出结果必须与朴素、未经优化但逻辑绝对正确的基准代码完全对齐。
属性测试库是防止 Agent“自欺欺人”的利器:这些边缘用例是由算法随机暴力构造的,完全独立于生成代码的 Agent 自身的归纳偏置。尤其在面临大型代码重构(Rewrites)时,当旧有的 Spec 文档已经与线上真实逻辑产生漂移、不再可信时,属性测试是检验重构正确性的救命稻草。
# 3. 差分测试(Differential tests):旧系统就是最权威的 Oracle
在业务逻辑理应保持完全不变的大规模架构重构与语言迁移(Migration)中,差分测试展现出了降维打击般的威力。其原理极其朴素直观:向旧系统与重构后的新系统灌入完全相同的输入流量,比对两者是否产生了任何输出差异。只要出现分歧,就意味着新系统引入了 Bug 或不兼容的破坏性变更(Breaking Change)。
差分测试成功的关键在于:使用海量随机生成的数据,或是直接录制真实生产流量的采样切片。同时,你需要对输出做一层规格归一化(剔除时间戳、空白符等无关细微干扰),并维护一份明确的“已知允许变更清单”,以便兼容那些新架构有意引入的合规变动。
# 二、Claude Code 团队如何构建验证体系
我们在过去的分享中曾介绍过 Anthropic 内部的代码审查机制,本文则将进一步深挖我们在日常工程中如何以体系化手段验证工作成果。
# 1. 验证的本质是真实运行变更(Verification means running the change)
让应用真实端到端跑起来,其权重远胜过堆叠抽象测试。正如你绝不可能在不经过模拟器真机预览的情况下就把 iOS 改动推向生产一样,对待 Claude 亦当如此。
Claude 完全可以像真实人类 QA 工程师一样去端到端验收应用:
- 针对前端 Web 变更,调度 Claude Chrome 扩展;
- 针对移动端,通过 iOS 或 Android MCP 驱动真机/模拟器;
- 针对桌面端,启用 Computer Use(计算机操作)能力;
- 针对后端服务,让其在本地沙箱中直接拉起进程并真实调用接口。
为了将“如何启动模拟器或运行服务”沉淀为可复用的工程标准,你可以在仓库的 .claude/skills/ 目录下创建一个名为 verify 的专用 Skill,并尽量将其贴近相关业务代码。Claude 在提交变更前,会自动识别并调用 verify Skill。
花大精力去优化你的 verify Skill,使其尽可能快速、可靠。让 Claude 反复对其进行压力测试与鲁棒性打磨——这是你的冒烟测试底座(Smoke Test Harness),必须坚如磐石。只要给 Claude 赋予了端到端冒烟测试的能力,它就能像人类工程师一样快速自省并捕捉到真实失误。在 Anthropic 内部,我们几乎所有的生产改动都是以这种方式验证的。
# 2. 失败的测试才需要人类介入(Failing tests require human attention)
在海量并发的 Agent 时代,没有任何人有精力逐行去肉眼审阅每一处代码变更。在 Anthropic,我们把“测试失败”作为决定是否需要人类介入的关键路由分流器:
Claude 负责跑全部检查并尽力尝试自动修复任何报错。只有当一项检查在经历三轮自我修复后依然持续报错,Claude 才会主动叫停并拉入人类工程师进行干预。
# 3. 代码 Owner 负责编写自己的检查器(Code owners write their own checks)
谁负责核心业务代码,谁就必须亲手为其定制专属的验证器,并持续调试提炼,直至检查器能精准捕获 Owner 本人平时 Code Review 时最看重的所有痛点。
同时,当一项自动化检查拉入人类评审员时,它必须清晰阐明“为何触发报警”,绝不能让评审员自己去 diff 里面大海捞针。
# 4. 稳定性检查器由 Diff 触发(Reliability checks trigger on the diff)
我们在内部维护了一份包含 39 个核心检查项的“系统稳定性检查清单(Reliability Checklist)”。每个检查项都由三部分构成:可从 Diff 中静态识别的触发条件、具体的检查逻辑、以及其背后历史上对应的真实故障案例或 PR 事故复盘。
例如,其中一条是“--resume 能够安全加载旧版本转录”。当 Session 存储结构或消息类型发生变更时,检查器会重点核实新字段在读取旧转录时是否具备安全的向下兼容能力,因为早期的转录中不可能包含新字段。
在执行时,Claude 会自动阅读 Diff,并且仅执行命中触发条件的特定检查项(通常只有 3 到 10 项)——如此一来,团队中的任何人都无需被迫死记硬背过去历史上发生过的所有故障。
# 5. 单评审员模式,多轮渐进式增强(One reviewer, multiple rounds)
我们并不推崇在 Review 流水线中盲目堆叠更多的模型评审员。在主评审员之上再叠加一个更昂贵的二级评审员,其效果通常远不如集中精力把主评审员的行为调优到极致。
在 Claude Code 体系中,我们在仓库中维护专属的 REVIEW.md 规则文件,向模型清晰定义针对当前模块在 Review 时最应重点关注的维度。
此外,多轮审校和验证必须具备上下文累进性(Build on each other):每一轮 Pass 应当站在前几轮的历史上下文与过往失败经验之上推进,而不是每次都从零开始无脑重查全量内容。这种方式不仅开销极低,而且能挖出更隐蔽的深层缺陷。
# 6. 业务变更绝对无权修改裁决自身的检查器(Changes can't modify their own checks)
如果一项业务变更能够顺手修改负责裁决它的检查规则,那么这项检查就已经在安全和工程意义上彻底作废。
在 Claude Code 架构中,Code Review 机制读取的 REVIEW.md 规则文件,必须且只能来自于主干基准分支(Base / Default Branch),绝不允许从当前 PR 提交的代码分支中读取。Claude Code 团队严格确保:卡死代码合规门禁的所有仲裁规则,必须全部独立驻留在业务分支绝对无权篡改的隔离分支上。
同时,严格只对不可变提交(Commits)发起 Review:如果有人在 Review 执行期间持续向分支追加 push,此前的 Review 判定结果直接作废——针对过时 Commit 的绿灯没有任何意义。
不仅如此,优先运行廉价检查:如果一个 Agent 在本地尚未跑通测试就冒失推向远端,就会白白挥霍公共的 CI 算力与评审时间。在我们的团队中,Claude 必须在开启 PR 之前,在本地先跑通全部单元测试、构建和 Linter。你可以通过 Hook 机制或配置 /goal 来强制硬性约束必须全套测试套件绿灯。
# 7. 全新门禁一律先在“观察模式(Observe Mode)”下上线
在 Anthropic 自己的仓库中,我们为每一次 Commit 打上其验证方式的溯源戳记(甚至包含 none,以便快速检索那些逃逸未经验证的提交)。
我们还构建了专门的 Commit 门禁:如果在当前 Session 中未执行 /code-review 或 /verify,则拦截提交。该门禁设计了三种模式:off(关闭)、observe(观察)以及 enforce(强制生效)。
新门禁刚上线时一律置于 observe 模式:系统仅默默记录下“哪些提交在未来会被拦截”,以便工程师复盘所有假阳性误报(False Positives),确保正常开发节奏零阻碍;
当进入 enforce 模式后,门禁会强力拦截违规提交。提交者可以在 Commit Message 中解释未经审核的合规理由;同时,若同一 Session 内已被连续拦截两次,第三次将自动豁免放行,以避免因 Claude Code 当前偶尔的误判而导致死锁卡死——必须承认,当前的 Claude Code 并非完美无瑕。
# 8. 基于真正有价值的实际指标来考验检查器(Test your checks on what actually matters)
Claude Code 团队会定期对负责 Review 的模型自身展开严苛评估。我们深度追踪三大真实指标:
- 已合并的变更中有多少最终被 Revert 回滚;
- Maintainer 在合并前主动驳回了多少次不合格变更;
- 以及一套规模匹配、且在线上保持绝对稳定未曾出过问题的基准变更子集。
这也演化为极其正规的离线评估机制(Formal Evaluation):基于历史真实的故障 incident 和 Revert 记录构建评测集。针对每个测试案例,将仓库还原至当时提交审查时的精确历史状态,并配备一份描述该 Bug 确切实质的一句话“标准答案(Answer Key)”。只有当检查器精准指出该 Bug 的核心本质时,才能得分;同时用那些已合并且稳定的优质 PR 作为对照组(Control),防范检查器出现“全面狂吠”的过度报警(Over-flagging)。其参数微调集(Tuning Set)与最终严苛评测的固定测试集(Fixed Test Set)保持严格的物理隔离。
此外,团队将召回率(Recall Rate)细分为三个独立流水线节点分别测算:原始初筛线索(Raw findings)、验证后线索(Post-verification)、以及最终决策(Final review)。这能精准洞察系统是否在后半程把本已发现的严重 Bug 意外弄丢了。任何仅看首尾端到端单一分数的评测体系,都无法洞察这一致命流失。
在有效性之外,另一个关键维度是问题的优先级定级:一个合格的审校者不仅要挑出技术瑕疵,更要向工程师清晰界定该 Bug 属于“必须修复(Must-fix)”、“建议修复(Should-fix)”还是单纯的“代码洁癖(Nit)”。Claude Code 的 Code Review 具备专属标签机制,将问题划分为 Important、Nit 以及 Pre-existing(已存在问题:审校者不应把原本就存在的老 Bug 归咎于当前作者)。最后,团队对召回率的调优严格克制在“再提升就会对评测集过拟合”的临界点上。
# 9. 将每一次漏网之鱼沉淀为长效规则(Turn misses into rules)
在 Claude Code 仓库中,我们有两种将漏网之鱼沉淀为长效规则的标准手段:
- 第一种方法:系统性提取人类工程师在 PR Review 中的真实 Review 评论,以及 PR 被 Revert 的复盘记录。任何潜在问题必须在至少 2 个独立的 PR 中反复出现,并且必须能够从 Diff 中静态识别,才能被提名候选。随后,系统会派出 3 个独立的 Agent 尝试寻找反例去“证伪”它,最终由人类工程师在 PR 中审核批准合入;
- 第二种方法:针对已知发生线上故障的 PR,调动 3 个独立的 Bug Finder 探测器进行回放测试。若至少有 2 个探测器抓住了 Bug,说明它具备可检性;如果一个 Bug 在极其短小精悍的 Diff 中被意外漏掉,这就构成了极高价值的规则盲区,值得将其直接写进
REVIEW.md。
对于不稳定的测试(Flaky Tests)同样享受此等待遇:Claude 绝不允许通过“添加 sleep 延时”或“死循环重试”来蒙混过关。如果它无法定位出根本原因,它就必须果断删掉该单测,并详细附上删除原因;
规则同样需要定期除草与清理:测试套件、验证步骤和 .md 规则文件如果不加节制只会无限膨胀,因此我们定期会执行修剪优化。
# 三、好的测试产出好的结果(Good tests, good results)
我们深刻体会到,为 Agent 配备一套拥有强反馈闭环的自我验证机制,是决定成败的关键分水岭。
请像对待任何关键生产系统一样严肃对待你的“验证层”:
- 让其绝对独立于它所裁决的业务变更之外;
- 用那些真正让你肉痛过的真实事故来给验证层打分;
- 一旦漏掉故障,立刻将教训沉淀为不可动摇的规则,杜绝同一块石头绊倒两次;
- 定期修剪这些规则,确保它们维持最高的信息密度。
做到这几点,你的日常核心角色就将从“痛苦地逐行肉眼硬啃每一个 Diff”,彻底升维为**“清晰定义业务完成的标准(Done Criteria)并审视智能体呈递的确凿证据”**——而这,正是让你能同时从容指挥数十个 Claude 协同作战的真正秘密武器。